如何用 Amazon Bedrock AgentCore 構建環境式智能體,串聯事件觸發與人在迴路工作流
Building ambient agents with Amazon Bedrock AgentCore: From event-driven signals to human-in-the-loop workflows
Amazon Bedrock AgentCore 的參考實作把 Amazon S3 上傳或排程事件轉成智能體工作,並讓智能體在需要澄清、審批或覆核時暫停等待人員回應。
文章把事件來源、AgentCore 執行與人在迴路處理串成參考架構,並清楚區分樣本內建能力與需自行擴展的訊號來源。
大規模處理文件的團隊都熟悉這套流程:檔案存入儲存空間,有人留意到後逐一開啟、判斷需要怎樣處理,再送交審核。監控警示也會以同樣方式排隊,等候人手處理。人工分流浪費的時間,正是環境式智能體要解決的營運問題。試想有文件放進 Amazon Simple Storage Service(Amazon S3)儲存貯體後,幾秒內便有工作出現在 Jobs 頁面,隨時可以執行(如果你有這樣設定,甚至已經開始執行)。智能體會分析檔案、整理發現,並在採取下一步行動前徵求你的批准。事件本身就是提示。這就是環境式智能體:它回應事件串流,需要時透過單一 ask_human 工具暫停並等待人類輸入;收到回覆後,便從中斷處繼續執行。
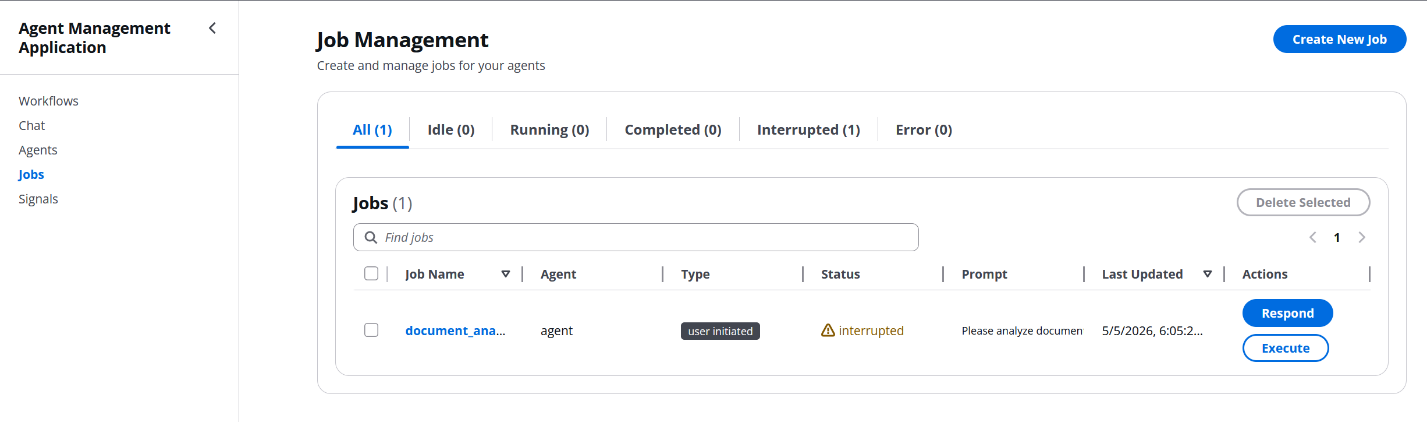
圖 1:環境式智能體在 AgentCore Runtime 上回應事件,並暫停以等待人類輸入的概覽
現今大部分 AI 智能體體驗都採用另一種模式:用戶開啟聊天介面、輸入提示,再等待回覆。這適合一次性的問題,但智能體一次只能處理一段對話,而且任何事情要開始處理前,都需要人類先描述發生了甚麼。當智能體需要回應基礎設施各處發生的事件(檔案上載、資料庫變更、排程工作、系統警示)時,純聊天模式便行不通。
環境式智能體代表一種不同範式,LangChain 等機構也曾闡述這個概念。它們不會等用戶發起對話,而是監聽事件串流並據此採取行動,甚至可以平行處理大量事件。它們並非只由人類訊息觸發,也可同時運行多個智能體。關鍵是,它們並非完全自主:生產環境設計會仔細考慮智能體何時需要暫停並與人類互動。收到訊號後,智能體會執行工作流程,只在需要澄清、批准或審核時才打斷人類。這個人在迴路(human-in-the-loop)環節降低了把智能體部署至生產環境的風險、建立用戶信任,亦讓智能體可透過回饋持續學習和改進。
使用 AWS 的機構通常已具備事件驅動基礎設施:Amazon S3 事件通知、Amazon EventBridge 規則、AWS Lambda 觸發器和 Amazon DynamoDB 串流。欠缺的是把這些事件來源連接至能推理事件、採取行動,並在適當時邀請人類參與的智能體。AWS Step Functions 等全自動化管道可以協調工作流程,卻無法推理模糊情況或提出澄清問題。聊天式智能體能推理,但需要有人先展開對話。環境式智能體正好填補這個空隙。
Amazon Bedrock AgentCore 是一個可使用任何框架或模型,大規模建置、連接和最佳化智能體的平台。AgentCore Runtime 提供這種模式所需的執行環境:以容器託管智能體、支援長時間運行工作、內置工作階段隔離,並整合 Amazon Bedrock 基礎模型。AgentCore Runtime 支援足夠長的工作階段,涵蓋此處展示的「訊號 → 智能體 → 人在迴路」流程。參考實作將每輪智能體執行上限設為 Lambda 的 15 分鐘逾時時間;實際上這已留有充足餘裕。再配合負責事件處理的 AWS Lambda 和負責狀態管理的 Amazon DynamoDB,便可建立完整的無伺服器環境式智能體平台。
本文會端到端介紹在 Amazon Bedrock AgentCore 上實作這種模式。你將瞭解:
- Amazon S3 或排程事件如何變成由 AgentCore Runtime 上的智能體執行的工作,無論有沒有人介入都一樣。
- 只需一個
ask_human工具加上標準回應封套,便足以支援各類人在迴路互動。 - 參考範例提供甚麼,以及你需要為自己的用途自行編寫甚麼。
先決條件
部署參考實作前,請先準備以下項目:
- 一個具備權限的 AWS 帳戶,可建立 AWS Identity and Access Management(IAM)角色、Lambda 函數、DynamoDB 資料表、S3 儲存貯體、Amazon Simple Queue Service(Amazon SQS)佇列、Amazon API Gateway API、Amazon CloudFront 發佈、Amazon Cognito 用戶集區、Amazon Elastic Container Registry(Amazon ECR)儲存庫,以及 Bedrock AgentCore 執行環境。在沙盒帳戶中使用管理員權限,是個不錯的起點。
- 已設定好憑證和預設 AWS 區域的 AWS Command Line Interface(AWS CLI),預設區域為
us-east-1(範例預設值已設為該區域)。 - 已在帳戶和區域安裝並完成 bootstrap 的 AWS Cloud Development Kit(AWS CDK) v2(
cdk bootstrap)。 - 本機已安裝並正在執行 Docker。部署時會建置智能體容器並推送至 Amazon ECR。
- 後端 Lambda 函數和智能體建置需要 Python 3.11 或更新版本;React 前端則需要
Node.js18 或更新版本。 - 在目標區域可使用 Amazon Bedrock 上的 Anthropic Claude Sonnet 4.5 模型。如果你尚未使用 Bedrock,請依照管理 Amazon Bedrock 基礎模型的存取權(FMs)指引啟用模型。模型供應情況因 AWS 區域而異,請查閲 Amazon Bedrock 文件,瞭解目標區域目前支援的模型清單。稍後只需修改一行設定即可切換模型。
認識環境式智能體
開始介紹架構前,先了解環境式智能體與一般聊天機械人的分別,以及本文其餘部分會依賴的基本元件:事件驅動觸發模式、環境訊號抽象層,以及把兩者連繫起來的單一人在迴路工具。
事件驅動與用戶發起的智能體
用戶發起的智能體採用請求-回應模式:
User → Prompt → Agent → Response → User環境式智能體採用事件驅動模式:
Event → Signal → Agent → [Optional human interaction] → Action關鍵分別在於觸發機制。環境式智能體由系統事件而非明確的用戶請求啟動,因此很適合用於文件處理管道、監控和警示、排程分析,以及需要逐步取得批准的多步驟工作流程。
環境訊號:觸發機制
環境訊號是一項把事件來源對應至智能體的設定。事件發生時,平台會自動為智能體建立工作。之後會發生甚麼,取決於訊號上的一項設定:
- 若
autoExecute: false(預設值),工作會以idle狀態出現在 Jobs 頁面,等待人類審核和執行。若訊號可能因未知輸入而觸發,或智能體可使用高風險工具,這種先審核的流程最安全。 - 若
autoExecute: true,訊號處理器會直接把工作放進 worker 佇列,智能體隨即執行;只有智能體本身呼叫ask_human時才會請人類介入。這就是全自主流程。
這種模式涵蓋多種訊號事件來源。參考範例已提供前兩種;其餘是擴展點,可新增 handler Lambda 函數和 Signals 頁面的相應表單欄位來擴展:
- Amazon S3 檔案上載(已提供):當檔案上載至指定儲存貯體和前綴時觸發。
- 排程事件(已提供):按類似 cron 的排程觸發智能體。這由帶有
jobType: "scheduled"的工作驅動,而非由 Signals 頁面的訊號驅動。 - API webhook(擴展點):回應外部系統通知。
- 資料庫變更(擴展點):回應 Amazon DynamoDB 串流或 Amazon Relational Database Service(Amazon RDS)事件。
人在迴路:一個工具、一個封套、一個檢視
環境式智能體需要有結構地與人類互動。在這個範例中,智能體透過單一工具(ask_human)呈現互動,並傳回標準回應封套。封套中的 status 可以是 completed、interrupted 或 error,而相應欄位分別是 result、question 或 error。平台也會在每個回應中傳遞 session_id 和 job_id,以便對應後續執行回合。這些是關聯中繼資料,並非智能體必須實作的核心合約。智能體傳回 interrupted 時,平台會把工作狀態改為 interrupted,並把 requiresAction 旗標設為 true。參考 React 前端會在 Jobs 頁面的 Interrupted 分頁顯示這些工作,並在每列加入警示標記,因此不需要另外輪詢審核佇列。同一個 Jobs 檢視會顯示待答問題、等候批准的建議行動、最終結果和失敗工作,讓用戶在一處查看智能體的所有活動,不必監看多個聊天視窗或電郵對話。
同一機制支援智能體文獻中常見的多種提示模式:智能體單純報告結果的 Notify 回合、提出澄清問題的 Question 回合、提出行動建議並等候 APPROVE / REJECT / MODIFY 的 Review 回合,以及把錯誤記錄在工作紀錄上、由用戶決定是否重試的 Error 回合。這些只是智能體撰寫問題的慣例,並非不同的執行模式。在平台層面,始終只有一條程式路徑和一個封套。
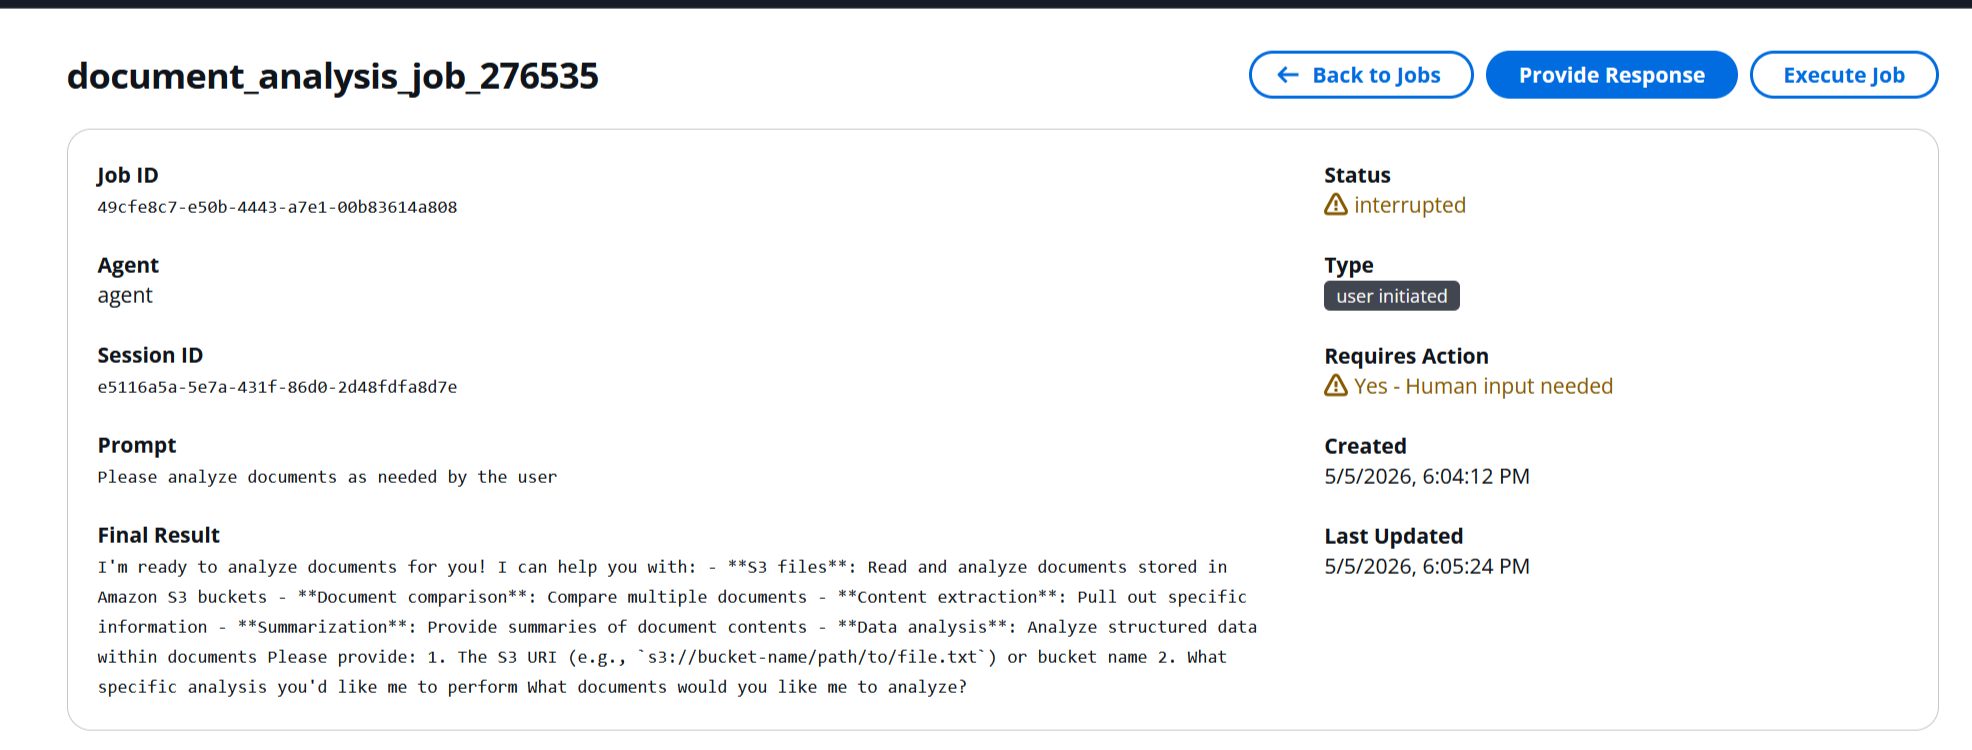
圖 2:Notify、Question 和 Review 三種人在迴路模式,全部透過 ask_human 工具呈現
架構概覽
這個平台由一小組透過事件管道連接的無伺服器元件組成。本節先介紹端到端流程,再逐一説明各個元件。
事件會按以下流程端到端經過平台:Amazon S3 發出 s3:ObjectCreated 通知,由 Signal Processor Lambda 函數接收。Signal Processor 會查詢環境訊號資料表上的全域次要索引(GSI),找出與事件儲存貯體相符的訊號,再為每個符合項目建立工作記錄。API 層(或排程器)會把工作放入 Amazon SQS 佇列。負責 API 路徑的同一個 Job Execution Lambda 函數,也會透過已連接的 SQS 事件來源清空佇列、在 Amazon Bedrock AgentCore Runtime 上呼叫智能體,並把結果(及任何人類輸入請求)寫回 Amazon DynamoDB。React 前端透過 Amazon CloudFront 從 Amazon S3 提供服務,並輪詢小型 Amazon API Gateway 和 Lambda 層以取得更新,讓用戶可回應待處理互動。
主要元件包括:
- Amazon S3 透過事件通知,在檔案上載時作為訊號入口。前綴和後綴篩選條件會直接加入儲存貯體的通知設定,確保只會為可能符合訊號的事件呼叫訊號處理器。
- Amazon SQS 把 API Gateway 請求與智能體呼叫分隔。工作執行佇列會保存待處理工作;如果 worker 在已設定的重試次數後仍無法處理訊息,死信佇列(DLQ)便會接收該訊息。
- 三個管道 Lambda 函數負責把事件由接收階段送至智能體(本節稍後會介紹 API Gateway 後方獨立的管理層):
- Signal Processor 會把收到的事件與已設定訊號定義配對,並建立工作。
- Job Execution 在同一個 Lambda 函數中提供兩條入口路徑:負責排入訊息的 API handler,以及負責接收訊息並在工作上下文中呼叫 AgentCore Runtime 的 SQS worker。
- Scheduler 每分鐘按 cron 觸發一次,並把到期的排程工作放入同一個 SQS 佇列。
- Amazon Bedrock AgentCore Runtime 會在隔離容器中執行智能體程式碼,並支援長時間運行的工作。
- Amazon DynamoDB 儲存智能體登錄資料、工作記錄、環境訊號定義、聊天對話串、對話歷史和 Powertools 冪等性記錄。對話訊息會透過
UpdateItem+list_append原子方式附加,避免並行寫入互相覆蓋。 - 五個位於 Amazon API Gateway 後方的管理層 Lambda 函數,會提供前端使用的 REST API(
agent_management、job_management、signal_management、chat_management、conversation_management);另有一個chat_executionworker Lambda,供chat_management非同步呼叫,讓聊天 API 呼叫可以即時返回。如何配置這些元件,請參閲生產部署。 - React 前端透過 Amazon CloudFront 從 Amazon S3 提供服務,呈現 Agent Management UI,讓用戶監察工作、與智能體聊天、回應問題和審核待處理行動。
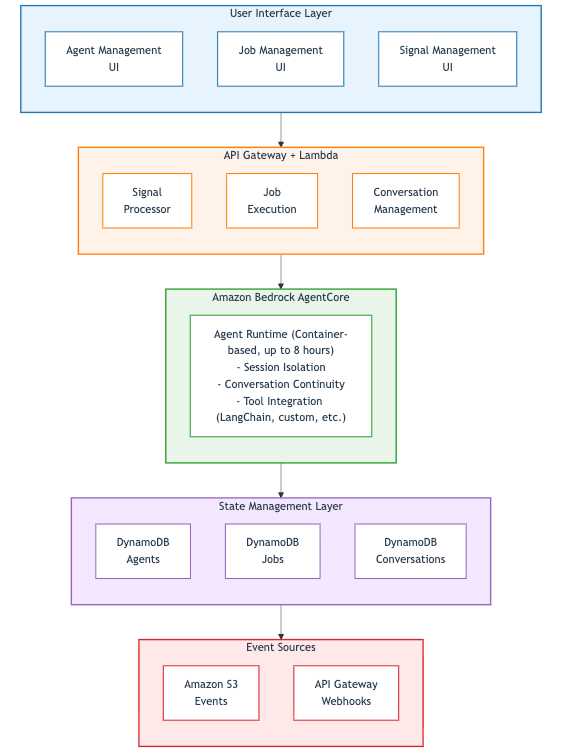
圖 3:事件由 Amazon S3 經 Amazon SQS 和 AWS Lambda 流向 AgentCore Runtime,狀態儲存在 Amazon DynamoDB,並由 React 前端呈現
建置事件基礎設施
瞭解架構後,下一步是接通事件來源,讓 Amazon S3 上載轉換成智能體工作。本節會建立儲存貯體、把事件通知指向 Signal Processor Lambda 函數,並説明處理器如何把事件與已設定訊號配對。
設定 Amazon S3 訊號觸發器
建立 Amazon S3 儲存貯體,並設定事件通知以觸發 Signal Processor:
aws s3 mb s3://amzn-s3-demo-bucket-$(date +%s)儲存貯體已設定為把 s3:ObjectCreated:* 事件直接傳送至 Signal Processor Lambda 函數。在這個範例中,建立或更新訊號時,signal_management Lambda 函數會動態安裝通知設定,因此新增指向新前綴的訊號不需要重新部署。
Signal Processor Lambda 函數
Signal Processor 會接收 Amazon S3 事件,在 DynamoDB 中尋找相符的訊號定義,並為每項相符項目建立工作。其 handler 的核心形態如下例所示。實際的 handler 位於 backend/functions/multi_agent/signal_processor.py,亦會使用 AWS Lambda Powertools 進行結構化記錄和冪等處理、查詢訊號資料表上的 bucketName-signalId-index GSI、套用各訊號設定的前綴和後綴檢查,並寫入 signal_triggered 工作記錄。
def process_s3_signal(event):
    """Process S3 file-upload events and create agent jobs."""
    for record in event["Records"]:
        bucket = record["s3"]["bucket"]["name"]
        key = record["s3"]["object"]["key"]

        for signal in find_matching_signals(bucket, key):
            create_agent_job(signal, {"bucket": bucket, "key": key})
訊號設定資料模型
訊號會以以下結構儲存在 DynamoDB:
{
  "signalId": "sig-123abc",
  "userId": "user-456def",
  "agentId": "agent-789ghi",
  "signalName": "Document Processor",
  "signalType": "s3_file_upload",
  "enabled": true,
  "autoExecute": false,
  "bucketName": "ambient-agent-documents",
  "configuration": {
    "bucketName": "ambient-agent-documents",
    "prefix": "invoices/",
    "suffix": ".pdf"
  },
  "triggerCount": 42,
  "lastTriggered": "2026-04-15T10:30:00Z",
  "createdAt": "2026-04-01T00:00:00Z"
}
透過 API 建立訊號時,只需設定 configuration.bucketName。前述範例頂層的 bucketName 由平台填入。由於 DynamoDB GSI 分割區索引鍵不能巢狀放在 map 屬性內,signal_management 每次寫入時都會把 configuration.bucketName 複製到頂層 bucketName,讓 bucketName-signalId-index GSI 能為每個 Amazon S3 事件找出相符訊號。
autoExecute 旗標是唯一用來決定由智能體自主執行,還是先由人類審核工作的開關。Agent Management UI 中的 Signals 表單會以核取方塊呈現此設定,並與常用的 enabled 設定並列;不用修改程式碼或資料庫,快速編輯即可更改行為。
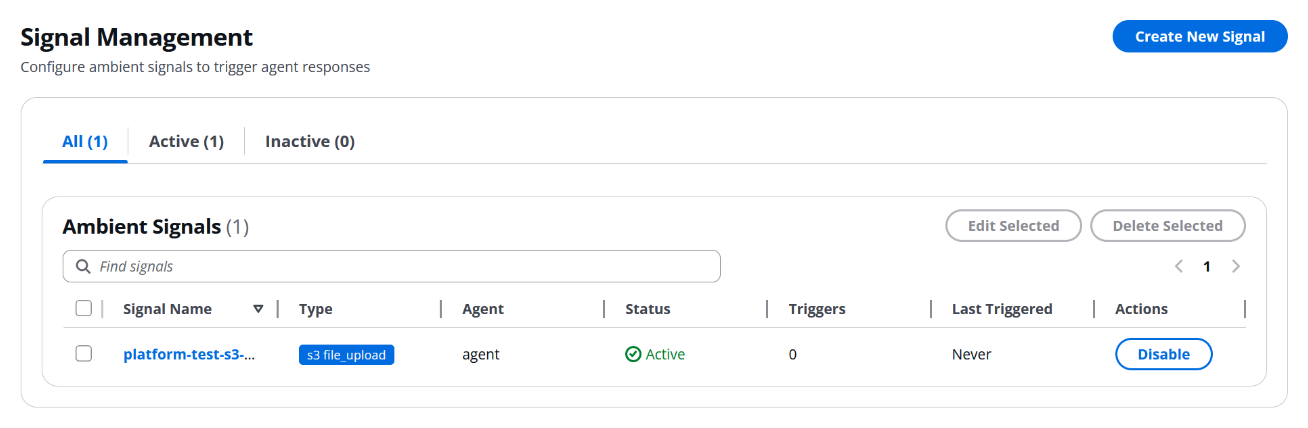
圖 4:Signals 頁面中的訊號定義及 autoExecute 開關
在 AgentCore Runtime 上部署智能體
Amazon Bedrock AgentCore Runtime 會託管智能體容器,並透過 InvokeAgentRuntime API 提供服務;worker Lambda 函數會在每項工作中呼叫該 API。本節會介紹範例所提供的智能體結構、控制其行為的設定,以及把 LangGraph 工具呼叫轉換成平台回應封套的小型協調器。
智能體封裝與結構
AgentCore Runtime 提供以容器為基礎的智能體執行環境,因此你可以選用任何 Python 智能體框架。範例採用模組化設計:
agent/
├── agent.py             # Entry point
├── config.yaml          # Agent configuration
├── requirements.txt     # Dependencies
├── core/                # Platform integration
│   ├── agent_core.py        # Main agent logic
│   ├── tool_factory.py      # Config-driven tool creation
│   └── execution_control.py # Session state + loop detection
└── tools/               # Custom tools
    ├── calculator.py        # Math operations
    ├── human_input.py       # Human-in-the-loop
    └── s3_reader.py         # Exports list_s3_files + read_s3_file
智能體設定
config.yaml 定義智能體行為、工具和系統提示。本教學範例預設使用 Amazon Bedrock 上的 Anthropic Claude Sonnet 4.5,適合人在迴路工作流程所需的多步驟工具呼叫和長上下文推理。若要切換至 Claude Haiku、Amazon Nova,或 Amazon Bedrock 上可用的其他工具呼叫模型(可用情況因區域而異),只需修改以下設定中的 model_id 一行。max_iterations: 10 讓圖表在停止前可執行約十輪模型至工具的往返(協調器會把此值加倍,計算 LangGraph 的遞歸上限,因為每輪往返會經過兩個圖節點),足以涵蓋範例中 S3、計算器和 ask_human 工具預期的多步驟使用情境。檔案亦包含 execution: 區塊(迴圈偵測器、斷路器、工作階段快取門檻),為簡潔起見此處省略。完整檔案請參閲 agent/config.example.yaml。
# Amazon Bedrock Configuration
aws:
  bedrock:
    model_id: "us.anthropic.claude-sonnet-4-5-20250929-v1:0"
    region_name: "us-east-1"

# Agent behavior
agent:
  verbose: true
  max_iterations: 10
  handle_parsing_errors: true

# Tool configuration (enables config-driven tool composition)
tools:
  calculator:
    enabled: true
    type: "calculator"
    name: "calculator"
    description: "Perform mathematical calculations."

  human_input:
    enabled: true
    type: "human_input"
    name: "ask_human"
    description: "Request input or clarification from a human user."

  s3_list:
    enabled: true
    type: "s3_list"
    name: "list_s3_files"
    description: "List files in an Amazon S3 bucket."

  s3_reader:
    enabled: true
    type: "s3_reader"
    name: "read_s3_file"
    description: "Read and analyze files from Amazon S3."

prompts:
  system_template: |
    You are a helpful AI assistant with access to a set of tools.
    Call tools only when they add value. Prefer concise answers
    grounded in tool results.
智能體核心實作
智能體以 langchain.agents.create_agent 為基礎,是編譯為 LangGraph 的工具呼叫智能體。LangChain 負責協調層,因為它提供預先建置的工具呼叫模式、廣泛的開放生態系整合,以及許多團隊熟悉的 API;AgentCore Runtime 則在底層提供受管理託管、工作階段隔離和擴展能力。兩層互相補足。平台在圖表外包裝的工作有三項:建立本輪訊息清單(包括對話歷史;若工作由訊號觸發,亦會包含觸發訊號的 Amazon S3 儲存貯體和 key,讓模型無需額外指示便可取得檔案)、呼叫圖表,以及掃描工具輸出中的 ask_human 標記,將工具呼叫轉為 interrupted 回應。
最簡單的形式如下(agent/core/agent_core.py 中的完整版本也會處理每個工作階段的歷史快取、迴圈偵測和執行追蹤):
from bedrock_agentcore import BedrockAgentCoreApp
from langchain.agents import create_agent
from langchain_aws import ChatBedrock
from langchain_core.messages import ToolMessage

from core.tool_factory import create_tools_from_config, load_config
from tools.human_input import HUMAN_INPUT_SENTINEL


class Agent:
    def __init__(self):
        self.config = load_config()
        self.llm = ChatBedrock(
            model_id=self.config["aws"]["bedrock"]["model_id"],
            region_name=self.config["aws"]["bedrock"]["region_name"],
        )
        # Tools are built from config.yaml so enabling a tool is a
        # config change rather than a code change.
        self.tools, _ = create_tools_from_config()
        self.agent_graph = create_agent(
            model=self.llm,
            tools=self.tools,
            system_prompt=self.config["prompts"]["system_template"],
        )

    def invoke(self, payload):
        """Run the agent graph for one turn. Simplified: the real method
        also loads conversation history, binds execution state on a
        ContextVar for tools to read, records an execution trace, and
        threads ``session_id`` and ``job_id`` through on every response
        so the platform can correlate continuation turns.
        """
        session_id = payload.get("session_id", "default")
        job_id = payload.get("job_id")
        result = self.agent_graph.invoke(
            {"messages": self._build_messages(payload)},
        )

        for msg in result["messages"]:
            if isinstance(msg, ToolMessage):
                content = str(msg.content)
                if content.startswith(HUMAN_INPUT_SENTINEL):
                    question = content[len(HUMAN_INPUT_SENTINEL):].strip()
                    return {
                        "status": "interrupted",
                        "question": question,
                        "session_id": session_id,
                        "job_id": job_id,
                    }

        return {
            "status": "completed",
            "result": self._extract_final_output(result["messages"]),
            "session_id": session_id,
            "job_id": job_id,
        }


app = BedrockAgentCoreApp()
agent = Agent()


@app.entrypoint
def invoke(payload):
    """AgentCore Runtime entrypoint. Delegates to the Agent wrapper."""
    return agent.invoke(payload)
部署智能體
使用提供的指令碼,把智能體部署至 AgentCore Runtime:
cd agent

# Configure AWS settings in .env and any overrides in config.yaml.
# Then build the container, push to Amazon ECR, and register it with
# Bedrock AgentCore Runtime.
./deploy_agent.sh
指令碼會傳回 Agent Runtime Amazon Resource Name(ARN),後端會把它儲存在智能體登錄資料中,供 Job Execution Lambda 函數呼叫。
使用 DynamoDB 管理狀態
Amazon DynamoDB 是所有需要超越單次 Lambda 呼叫而保存的資料之記錄系統:已註冊哪些智能體、哪些工作正在執行、令智能體能在不同回合延續上下文的對話歷史,以及 UI 讀取的訊號定義和聊天對話串。以下小節會介紹資料表配置、工作階段模型,以及 Job Execution Lambda 函數如何運用兩者推進工作直至完成。
資料庫設計
狀態層由 DynamoDB 支援。本文會用到的核心資料表包括:
智能體登錄資料表(每個已註冊智能體執行環境一筆記錄):
{
  "agentId": "agent-123abc",
  "agentName": "Document Analyzer",
  "agentArn": "arn:aws:bedrock-agentcore:us-east-1:123456789012:agent-runtime/abc123",
  "status": "active"
}工作登錄資料表(每次智能體呼叫一筆記錄)。使用預設設定 autoExecute: false 時,新建立的訊號觸發工作會以 idle 狀態存放於此,等候用戶選擇 Execute:
{
  "jobId": "job-789ghi",
  "agentId": "agent-123abc",
  "sessionId": "session-xyz789",
  "jobName": "Signal: Document Processor - invoice.pdf",
  "jobType": "signal_triggered",
  "status": "idle",
  "requiresAction": false,
  "metadata": {
    "signalId": "sig-123abc",
    "triggerPayload": {
      "bucket": "documents",
      "key": "invoices/invoice.pdf",
      "eventSource": "s3"
    }
  }
}
工作執行期間,worker 會把 status 改為 busy。若智能體呼叫 ask_human 暫停,status 會變成 interrupted,而 requiresAction 會變成 true,令工作顯示於 Jobs 頁面的 Interrupted 分頁。
對話儲存資料表(每個工作階段的完整訊息歷史,保留時間為 30 天):
{
  "sessionId": "session-xyz789",
  "agentId": "agent-123abc",
  "messages": [
    { "type": "human", "content": "Analyze this invoice", "timestamp": "2026-04-15T10:30:00Z" },
    { "type": "ai", "content": "Which category should I focus on?", "timestamp": "2026-04-15T10:30:30Z" }
  ],
  "ttl": 1778803200
}
另有環境訊號、聊天對話串和 Powertools 冪等性記錄資料表。排程執行會透過 jobType 和 nextRun GSI 重用工作登錄資料表,而不是使用獨立資料表。
工作階段管理
工作階段讓不同工作執行和聊天回合之間延續對話上下文。conversation_management Lambda 函數負責 DynamoDB 持久化:每輪對話(一組人類與 AI 訊息)都會透過原子式 UpdateItem + list_append 附加至工作階段,避免同一工作階段的兩個並行寫入者互相覆蓋;30 天 TTL 則負責清理。
延續對話上下文的工作執行
Job Execution Lambda 函數有兩條入口路徑。API 路徑會傳送 SQS 訊息(加入 Powertools 冪等性處理和 userId 擁有權檢查),並立即回傳 202 Accepted,讓前端毋須等待模型。真正執行工作的,是 SQS worker 路徑:它會載入對話歷史、把任何人類回覆整合至延續提示、呼叫 AgentCore Runtime,並寫回結果。worker 大致如下:
# Worker path - consumes the SQS queue and invokes AgentCore Runtime
def execute_task(job, human_response=None):
    session_id = job["sessionId"]
    agent_id = job["agentId"]
    if human_response:
        prompt = (
            "Previous conversation:\n"
            f"{load_conversation_context(session_id, agent_id)}\n\n"
            f"Human: {human_response}"
        )
    else:
        prompt = job["prompt"]

    response = bedrock_agentcore.invoke_agent_runtime(
        agentRuntimeArn=job["agentArn"],
        runtimeSessionId=session_id,
        # The SDK expects the payload as a JSON-encoded string.
        payload=json.dumps(
            {"prompt": prompt, "metadata": job.get("metadata", {})},
        ),
    )
    result = json.loads(response["response"].read())
    save_conversation_turn(
        session_id, agent_id, prompt, result.get("result", ""),
    )

    return {
        "status": result.get("status", "completed"),
        "sessionId": session_id,
        "result": result.get("result"),
        "question": result.get("question"),
    }
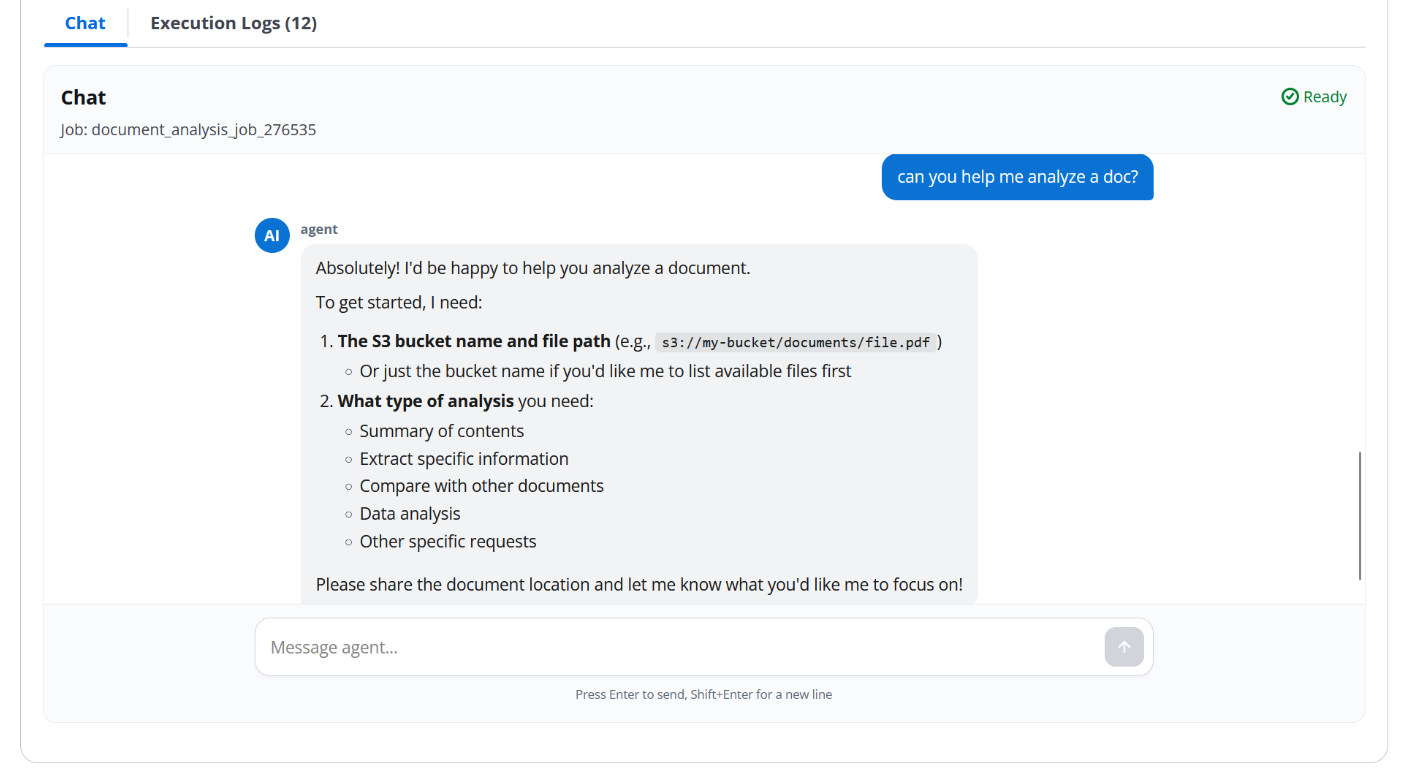
圖 5:工作執行順序,從 API 排入佇列、SQS worker 和 AgentCore 呼叫,到寫回 DynamoDB
實作人在迴路模式
前文的智能體程式碼會在圖表產生工具呼叫時,傳回帶有標記的 interrupted 封套;該工具呼叫為 ask_human。本節會深入介紹 ask_human 工具本身,並示範協調器如何捕捉該標記,同時不打斷推理迴圈。
人類輸入工具
人在迴路功能的核心是 ask_human 工具。它不會拋出例外:由於 LangGraph 的工具節點會把工具例外擷取為錯誤觀察並傳回模型,這個工具改為傳回一個標記字串。圖表完成後,協調器會在 ToolMessage 串流中偵測標記,並把它轉換成 interrupted 回應。每次呼叫專屬的狀態(指標、工作階段 ID 等)不會作為工具參數傳入;協調器會把它綁定至 ContextVar,工具再透過 current_execution_state.get() 讀取,確保同一容器中的並行呼叫彼此隔離。
from core.execution_control import current_execution_state

HUMAN_INPUT_SENTINEL = "__HUMAN_INPUT_REQUIRED__::"


def create_human_input_tool_func():
    """Create the ask_human tool function."""

    def ask_human_wrapper(question: str) -> str:
        """Request input or clarification from a human user.

        Returns a sentinel string that the orchestrator converts into
        an interrupt. The model never sees the sentinel because the
        orchestrator stops the graph when it is observed.
        """
        state = current_execution_state.get()
        if state is not None:
            state.execution_metrics.record_human_interaction()
        return f"{HUMAN_INPUT_SENTINEL}{question}"

    return ask_human_wrapper
智能體端的使用方式
智能體會在工具呼叫迴圈中自然使用這個工具。例如,分析一張有多個明細項目的發票時,智能體可能會呼叫:
Tool call: ask_human
Arguments: {
  "question": "This invoice spans three expense categories. Should I analyze Hardware, Services, or Software Licenses in detail?"
}
工具會傳回標記,協調器隨即停止圖表,把問題作為最新一輪 AI 訊息寫入對話儲存區,並向 UI 呈現 interrupted 工作。用戶回覆後,Job Execution Lambda 函數會再次呼叫智能體,把答案整合至延續提示。
建置 Agent Management UI
Agent Management UI 是平台面向人類的一端:用戶可瀏覽工作、回答待處理問題,並直接與智能體聊天。這是一個 React 單頁應用程式,會呼叫本文一直介紹的同一 REST API。以下兩節會介紹版面配置,以及把訊號、工作和人類輸入連繫起來的用戶體驗流程。
前端架構
前端是由 Amazon S3 提供服務、透過 Amazon CloudFront 發佈的 React 和 Cloudscape Design 單頁應用程式,設有五個分頁:
- Workflows:工作流程定義的圖庫和 CRUD 介面,可用來組織智能體和訊號。
- Chat:獨立聊天頁面(
/chat、/chat/:threadId),讓用戶與已註冊智能體對話。 - Agents:管理已註冊的智能體執行環境(名稱、ARN、功能和狀態)。
- Jobs:列出所有工作,提供狀態篩選和詳細檢視,並包含互動式 Chat 分頁、執行追蹤及中繼資料。
- Signals:定義和切換環境訊號。現有表單支援 Amazon S3 前綴和後綴篩選及排程;接通擴展點時,再加入 webhook、Amazon EventBridge 和 DynamoDB 串流欄位。
獨立 Chat 頁面和 Jobs 詳情的 Chat 分頁會重用同一聊天元件。工作執行期間(status === "busy"),面板會以短間隔輪詢 /conversations/:sessionId,讓智能體或第二個瀏覽器分頁發出的訊息在幾秒內顯示。工作結束後便停止輪詢。由於兩處使用同一元件,用戶可在工作進行時,直接從 Jobs 詳情檢視與智能體自由交談,不限於回答一個待處理問題。
用戶體驗流程
- 訊號觸發:Jobs 清單中會出現新工作,並帶有
jobType: "signal_triggered"。若訊號使用autoExecute: false(預設值),工作會以idle狀態建立,由用戶手動執行。若使用autoExecute: true,清單重新整理時,worker 已開始草擬回應。用戶發起的工作會帶有jobType: "user_initiated",並顯示不同標籤,讓你一眼分辨兩者。 - 要求人類輸入:任何呼叫
ask_human的工作都會移至 Interrupted 分頁,並把requiresAction旗標切換為true,在該列顯示警示標記。 - 回覆:詳情檢視會顯示 Provide Response 按鈕,讓用戶無需離開工作上下文即可回答待處理問題。
- 執行回饋:系統會輪詢狀態轉換(
idle→busy→completed|interrupted|error),並在清單和 Chat 分頁標題中反映狀態。 - 互動式聊天:Jobs 詳情的 Chat 分頁和
/chat頁面都會呈現完整對話歷史並接受新用戶訊息,讓人類可以回答待處理問題,或在不離開 UI 的情況下提供更多上下文,引導智能體。 - 提交回應:傳送訊息會呼叫 Chat Execution 或 Job Execution Lambda 函數;該函數會在 AgentCore Runtime 上呼叫智能體,並把工作上下文和人類回覆一併帶入下一輪。
- 完成與稽核:最終結果會儲存在工作記錄中,完整對話歷史則保存在工作階段,可於 Chat 分頁查閲和重用。
驗證由 Amazon Cognito 和 API Gateway CognitoUserPoolsAuthorizer 處理(參閲 backend/infrastructure/multi_agent_stack.py)。
即時更新透過輕量輪詢對話和工作端點實現,因此不需要運行 WebSocket 基礎設施。
擴展範例
參考實作刻意保持精簡,讓你先了解合約,再開始擴展。本節會説明範例內置甚麼、你要在其上建置甚麼,以及在哪裏接入新事件來源或工具。
範例提供甚麼,以及你要建置甚麼
開始擴展前,先了解各部分的邊界會比較有幫助。這是環境式智能體模式的參考實作,並非開箱即用的產品。內置項目包括:
- 平台:訊號接收、由 SQS 支援的工作管道、HITL 中斷機制、DynamoDB 中的工作與對話狀態、包含 Jobs 頁面和 Chat 介面的 React UI,以及具 Cognito 驗證的 AgentCore 整合。
- 參考智能體:容器化 LangChain 智能體,內含四個工具(計算器、
ask_human、list_s3_files、read_s3_file)和通用系統提示。它適合用來驗證端到端管道,不會一開始便替你解決業務問題。 - 透過 Signals UI 接通的一種訊號來源(Amazon S3 檔案上載,按儲存貯體、前綴和後綴配對),另有工作層級排程器,會以每分鐘一次的 cron 執行
jobType: "scheduled"工作。要加入 webhook、Amazon EventBridge 事件或 DynamoDB 串流等新訊號類型,必須同時擴展後端和 Signals 頁面表單中的signalTypeenum。
你要在其上建置的項目,以及平台對各項目的要求:
- 你的智能體:按你的領域需求打造的容器化 Python 智能體,具有專屬工具和系統提示。它必須遵守平台依賴的兩項慣例:傳回三種狀態的封套(
completed、interrupted或error,並包含相應的result、question或error欄位),以及使用ask_human標記要求人類輸入。無論你選用甚麼智能體框架,周邊大約只需 50 行 adapter 程式碼。 - 新增訊號類型:若 Amazon S3 上載和 cron 不足以應付需求,可新增 handler Lambda 函數來查詢訊號資料表並寫入
signal_triggered工作記錄(如下方範本所示),並在 Signals 頁面加入相應表單欄位,讓用戶設定。 - 新增智能體工具:在
agent/tools/下新增模組、在agent/core/tool_factory.py註冊,並在config.yaml加入啟用旗標。協調器和 HITL 流程毋須更改。任何傳回字串的工具都可加入同一圖表。
簡而言之:平台負責接線,你負責智能。你要編寫程式碼的三個位置(智能體邏輯、工具實作和新訊號 handler)都會接入現有合約,無須改動堆疊其他部分。
以設定取代程式碼
為現有智能體啟用新能力,只需修改設定而毋須改動程式碼。智能體的 config.yaml 會開啟或關閉工具,並提供工具説明;因此新增 Amazon S3 前綴 handler 或新的計算器模式,不必重新建置容器。訊號定義儲存在 DynamoDB,並透過 UI 中的 Signals 頁面編輯。
新增訊號類型
目前訊號會在 Amazon S3 事件和 cron 排程時觸發。新增 webhook、Amazon EventBridge 規則、DynamoDB 串流或 Kafka topic 等類型時,遵循相同的三步合約即可。下游管道與訊號類型無關:從 SQS worker、AgentCore 呼叫到 UI,所有元件都會以相同方式處理 signal_triggered 工作,因此你只需編寫一個橋接程式,將事件來源轉換成工作記錄。
# backend/functions/multi_agent/webhook_signal_processor.py (new file)
import json, os, uuid, boto3
from datetime import datetime, timezone
from boto3.dynamodb.conditions import Key

dynamodb = boto3.resource("dynamodb")
sqs = boto3.client("sqs")
signals = dynamodb.Table(os.environ["AMBIENT_SIGNALS_TABLE"])
# The jobs table env var is named TASK_REGISTRY_TABLE for historical
# reasons; the table itself holds the same job rows the rest of the
# blog refers to.
jobs = dynamodb.Table(os.environ["TASK_REGISTRY_TABLE"])
QUEUE = os.environ["JOB_EXECUTION_QUEUE_URL"]


def handler(event, _context):
    """Webhook -> ambient job. Invoked behind API Gateway."""
    payload = json.loads(event.get("body") or "{}")
    source = payload.get("source", "unknown")

    # 1. Find enabled webhook signals matching this event source.
    resp = signals.query(
        IndexName="signalType-source-index",  # add this GSI in CDK
        KeyConditionExpression=Key("signalType").eq("webhook") & Key("source").eq(source),
        FilterExpression="enabled = :e",
        ExpressionAttributeValues={":e": True},
    )

    for signal in resp.get("Items", []):
        job_id, session_id = str(uuid.uuid4()), str(uuid.uuid4())
        now = datetime.now(timezone.utc).isoformat()
        auto = bool(signal.get("autoExecute", False))

        # 2. Write a job row using the same shape the S3 path uses.
        jobs.put_item(Item={
            "jobId": job_id,
            "userId": signal["userId"],
            "agentId": signal["agentId"],
            "jobName": f"Signal: {signal['signalName']} - {source}",
            "jobType": "signal_triggered",
            "status": "busy" if auto else "idle",
            "sessionId": session_id,
            "prompt": f"Webhook from {source}:\n{json.dumps(payload)}",
            "requiresAction": False,
            "createdAt": now, "updatedAt": now,
            "metadata": {"signalId": signal["signalId"],
                         "signalType": "webhook",
                         "triggerPayload": payload,
                         "autoExecute": auto},
        })

        # 3. Enqueue if the signal is configured to auto-execute.
        if auto:
            sqs.send_message(QueueUrl=QUEUE,
                             MessageBody=json.dumps({"jobId": job_id,
                                                     "signalTriggered": True,
                                                     "signalId": signal["signalId"]}))

    return {"statusCode": 202, "body": "accepted"}
在 CDK 堆疊加入 Lambda 函數和 API Gateway 路由,在前端 TypeScript union 和 Signals 頁面表單擴展 signalType;其餘元件(Jobs 頁面 UI、ask_human 中斷處理、對話持久化、autoExecute 開關及合約測試)都會直接適用,無須更改。與生產環境的 Signal Processor 一樣,真正的 webhook handler 也應加入 AWS Lambda Powertools 冪等性處理,避免重試送達時重複建立工作。
部署至生產環境
各部分在本機整合完成後,下一步是在帳戶中佈建。整個平台會以單一 AWS CDK 堆疊部署。以下小節會説明該堆疊會建立甚麼、部署指令、運行期間值得留意的指標,以及範例預設的安全和擴展設定。
以程式碼管理基礎設施
整個平台是定義於 backend/infrastructure/multi_agent_stack.py 的 AWS CDK 堆疊。儲存和訊息部分會佈建多個 DynamoDB 資料表(智能體登錄、工作登錄、對話儲存、環境訊號、聊天對話串、冪等性記錄),並採用隨需計費和時間點復原;另會建立 SQS 工作執行佇列及其死信佇列。
運算和交付部分會佈建架構章節所述的三個管道 Lambda 函數(Signal Processor、Job Execution、Scheduler)、支援 REST API 的五個管理層 Lambda 函數(agent_management、job_management、signal_management、chat_management、conversation_management),以及一個 chat_execution worker Lambda,供 chat_management 非同步呼叫;此外還有以 Cognito 為後端的 REST API,以及負責提供 React 前端的 CloudFront 發佈。
IAM 權限直接由程式碼配置:每個資料表使用 DynamoDB grant_read_write_data;按需要授予 SQS grant_send_messages 和 grant_consume_messages;worker 角色則使用範圍受限的 bedrock-agentcore:InvokeAgentRuntime 政策。
部署步驟
# Clone the sample
git clone https://github.com/aws-samples/sample-ambient-agent.git
cd sample-ambient-agent

# Deploy the backend (CDK) and build / deploy the frontend
cd backend
pip install -r requirements.txt
cdk bootstrap   # first time only
cdk deploy --all

cd ../frontend
npm install
npm run build

# Deploy the agent container to Bedrock AgentCore Runtime
cd ../agent
./deploy_agent.sh
監控與可觀測性
Lambda 函數會在 AmbientAgents 命名空間下,為此模式的重要事件輸出自訂 CloudWatch 指標:訊號配對、工作排入佇列、工作完成、工作中斷和工作錯誤。配合預設 Lambda 和 SQS 指標(呼叫次數、錯誤、佇列深度、DLQ 深度),你便能建立儀錶板,端到端查看「訊號 → 工作 → 智能體 → 人類」流程。請先為 DLQ 深度設定警示,作為防止靜默失敗的第一道防線。
安全最佳做法
- IAM 最小權限:只授予各 Lambda 函數所需權限(讀取其專屬資料表、指定範圍的
bedrock-agentcore:InvokeAgentRuntime權限,以及特定 Amazon S3 前綴的權限)。 - 靜態加密:所有 DynamoDB 資料表均使用 AWS 管理的金鑰;Amazon S3 儲存貯體使用 S3 管理的加密;CloudFront 記錄則存放於專用記錄儲存貯體。
- 傳輸中加密:所有 API Gateway 端點和 CloudFront 發佈都必須使用 HTTPS。Amazon S3 儲存貯體政策會強制使用 SSL。
- 稽核記錄:AWS CloudTrail 會擷取整個堆疊中的 API 呼叫。你可以在工作資料表啟用 DynamoDB 串流,以取得更詳盡的工作生命週期稽核資料。
- 負責任的 AI:對智能體輸入和輸出套用 Amazon Bedrock Guardrails,讓內容篩選、拒絕主題和上下文依據檢查,能在發現結果顯示於 Jobs 頁面或透過
ask_human提示交給審核者前執行。這能保護人在迴路互動,並確保智能體輸出以來源文件為依據。
擴展策略
- Lambda 並行數:為 Job Execution worker Lambda 函數保留並行容量,將下游 Bedrock 呼叫限制在可預測的每帳戶上限。
- DynamoDB 容量:預設採用隨需計費。流量模式穩定後,可改用佈建容量並啟用自動擴展。
- 成本最佳化:使用 DynamoDB TTL 自動清理舊對話、使用 Amazon S3 生命週期政策淘汰已處理文件,並使用 CloudWatch 指標篩選器追蹤每個智能體的模型呼叫成本。
清理資源
完成範例評估後,請按建立時的相反次序拆除堆疊,避免繼續產生費用。
首先,從 Amazon Bedrock AgentCore 刪除智能體執行環境,停止容器計費:
aws bedrock-agentcore delete-agent-runtime \
    --agent-runtime-arn <your-agent-runtime-arn>
接着,清空堆疊佈建的 Amazon S3 儲存貯體(文件、前端託管和 CloudFront 記錄儲存貯體),讓 CloudFormation 可以刪除它們:
aws s3 rm s3://<amzn-s3-demo-documents-bucket> --recursive
aws s3 rm s3://<amzn-s3-demo-frontend-bucket>  --recursive
aws s3 rm s3://<amzn-s3-demo-logs-bucket>      --recursive
然後,銷毀 AWS CDK 堆疊本身,以移除 Lambda 函數、API Gateway、CloudFront 發佈、DynamoDB 資料表、SQS 佇列、Cognito 用戶集區和 IAM 角色:
cd backend
cdk destroy --all
最後,如果你不打算再次部署,請刪除智能體部署指令碼建立的 Amazon ECR 儲存庫:
aws ecr delete-repository \
    --repository-name ambient-agent \
    --force
若你只為本教學啟用了 Amazon Bedrock 模型存取權,之後不再需要,可以從 Amazon Bedrock 主控台的 Model access 頁面撤銷。
摘要
環境式智能體把 AI 自動化由「等候用戶」轉變為「回應訊號」。行動時間由數小時縮短至數秒,亦可全天候監控,而無需人類持續關注。每個智能體都在獨立、隔離的工作階段中運作,因此平台可以平行處理大量並行事件,無需額外協調。只有真正需要人類輸入時才會請人介入。統一的 Jobs 頁面免除在多種工具之間切換,而完整對話歷史則確保你不會忘記智能體做過甚麼或為何暫停。
何時適合採用環境式模式
以下用途説明環境式智能體模式的一般應用。參考範例目前已提供 Amazon S3 和排程器的管道;webhook、資料庫變更和外部整合則是可接入擴展點的功能。
只要環境中的事件能觸發模型可推理、而人類偶爾需要參與判斷的工作流程,這種模式便很合適。文件處理管道是典型例子:檔案存入後由智能體讀取、摘要,並在採取行動前徵求批准。監控和警示流程也適用同一模式:智能體先分流警示,只有需要升級處理時才詢問人類。排程處理、分析和報告自然適用 cron 路徑;任何需要批准關卡或人類檢查點的多步驟工作流程,也都能套用 ask_human 中斷機制。
有些工作則不適合使用環境式智能體。即時聊天應用程式應使用專為低延遲對話輪替設計的傳統聊天智能體。簡單的請求-回應 API 根本不需要智能體:一般 API 端點速度更快、成本更低,也更容易推理。純粹確定性、無需大型語言模型(LLM)推理的工作流程,仍應使用 AWS Step Functions。請留意,如果你需要 LLM 推理但不需要人類批准關卡,設定 autoExecute: true 的環境式智能體已涵蓋全自主情境。
後續步驟
複製參考實作,並依照最上層 README 進行部署和設定。
延伸閲讀:
由小處開始。選一個用途(文件處理或監控警示),再逐步擴展。複製範例、接上自己的事件來源,看看 Jobs 頁面能替你分擔多少例行工作。
作者介紹

Juan Albarran
Juan 是 AWS 前線部署工程(FDE)團隊的前線部署 AI 工程師。他直接與企業客戶合作,把複雜的生成式 AI 和機器學習概念轉化為可擴展應用程式,負責的專案涵蓋初期範圍界定、RAG 設計,直至使用 Python、Amazon Bedrock、Strands Agents、React 等技術完成全端實作。他曾帶領數十項高影響力合作專案,為多個行業交付度身訂造的智能體系統和可投入生產的 AI 解決方案。

Kenton Blacutt
Kenton 是 Frontier AI Engineering Services 團隊的資深深度學習架構師。他親自與客戶合作,協助他們使用尖端 AWS 技術解決實際業務問題,專注於智能體 AI。閒暇時,他喜歡旅行、試驗新的 AI 技術,也偶爾參加馬拉松。

Andy Widjaja
Andy 是 AWS 前線部署工程團隊的資深 AI 架構師,協助企業客戶設計並交付從原型到生產環境的智能體系統。他曾負責多項大型 AI 專案的技術交付,專注智能體協調、評估和可靠性。他在低延遲交易系統和大型文件處理平台等領域具備豐富經驗,樂於把尖端 AI 轉化為實際可用的解決方案。工作以外,他喜歡游泳、跑步和彈結他。

Omar Hamden
Omar 是 Amazon Web Services 的交付顧問,協助企業客戶現代化其應用程式,並在 AWS 採用生成式 AI。他專長於智能體 AI 系統、AI 驅動開發生命週期(AI-DLC)和多租戶平台設計,熱衷協助機構由試驗階段邁向生產級 AI 採用。
來源:AWS Machine Learning Blog · aws.amazon.com